【BigQuery】クエリの単体テストを書こうと思ったけど壁が厚くてどうしようか悩んでいる話
こんにちは。
久しぶりのブログ投稿になってしまったのですが、今日は「クエリの単体テストを書こうと思ったけど、壁が厚くてどうしようかなと思った話」を書きたいと思います。
はじめに言っておきますが、この記事は特に何か解決策があるわけでもなんでもなく、「ただ、クエリの単体テストを書こうとするとこんな問題にぶち当たって、それに対してこうしたらいいとは思ったけど、誰か最高のソリューションない?笑」って聞きたかったから書いただけの記事です笑*1
この記事のモチベ
最近、BigQueryを使ったデータ分析基盤とやらを開発しているのですが、「テスト書いてないとかお前それ @t_wada さんの前でも同じこと言えんの?」って言う状態になり、「これ真面目にやろうとするとどうなるんだ」って言うことで真面目に対峙してみました*2。
ここで言う「真面目に」と言うのは、「入り得る全パターンのデータに対する集計があっている」状態を指します。
自分もAPIの単体テストを書いたりとかは普通にやったことがあるのですが、データ集計系とか機械学習系とかのテストって、まぁなんというか「すみません、時間ないっす」ってしていました*3。書いたとしても、中途半端な、「これだけはあってるよ」って言うレベルです。
でも、やっぱ「ここだけは品質を落としちゃ行けねぇ*4」って言う部分をしっかり守りたいなという状況に出くわしまして、まぁやろうとなったわけです。
で、今回は色々検討した結果、「これってめちゃめちゃ大変だけどマジでどうするの?」っていうところについて書いていこうと思います。
前提
環境
環境としては、BigQueryを中心に話していきますが、やり方は違えど考え方は同じになるのではないかなと思います。
- データウェアハウス:BigQuery
- ワークフロー:Airflow (Cloud Composer)
BigQueryはエミュレーターが存在しないので、ローカルなどでテストが実行できませんので、実際に「BigQueryにテストデータを用意し、クエリを実行する」必要があります。
クエリの単体テストでやること
BigQueryにはエミュレーターが存在しないため、クエリの単体テストを書こうと思った時は、以下のような作業手順になると思います。
- 単体テストのために必要なテストデータを用意する
- テストデータを一時的にBigQuery上にテーブル化
- テストデータが入ったテーブルに対してテストのジョブをBigQuery上で実行
- テストのジョブの結果が、正解のデータと一緒かを判断する
- 処理が終わったら、作成したテーブルを削除する
実際の処理の実装方法についてはここでは細かく言及しませんが、大まかなフローはこのようになるかなと思います。
立ちはだかる3つの壁
上記のようなフローを想定し、早速テストを書いていこうと思ったんですが、3つの壁に会いました。
- データを網羅的に用意するのが非常にめんどくさい
- クエリがテストしやすいように書かれていない
- クエリの変更にある程度テストの処理が耐えれるようにする
それぞれについて書いていこうと思います。
壁①:データを網羅的に用意するのが非常にめんどくさい
クエリはそれ単体では動かないので、データを用意する必要があります。辛いよなぁって思っていたんですが、想像以上でした。
値の範囲が広すぎる
当たり前ですが、BigQueryにも型があります。以下のような感じです。
- STRING
- TIMESTAMP
- INT64
- FLOAT64
最初は、この値をベースにして、「Faker.jsとかを利用してダミーデータ生成すればええやんけ」って思っていました。
しかし、ここで問題が発生します。例えば、次のようなクエリです。
SELECT
  SAFE_CAST(revenue AS FLOAT64) AS revenue -- revenueはSTRINGです
FROM hogehoge
なんと言うことでしょう*5。ありがちな「とりあえずStringで入れて、後でなんとかしよう」作戦です。まぁこれは一概に間違っていなくて、本当にSTRINGが来ることもあるわけです。
ただし、STRINGだなぁと思ってダミーのデータを生成してもダメで、INTやFLOAT(マイナスから、ゼロ、プラスまで)の値をSTRINGの顔をして入れてあげないと言うことです。STRINGがくると言うことは、空白文字列も想定しないといけないよねとかもあります。
なので、普通に文字列だから文字列だけ生成してもダメだし、逆に数値しか来ないよねってたかを括ってはいけないみたいな感じです。辛い。
データを用意するライブラリがない
まぁ、作れよって言われたらそれまでなんですが、意外にめんどくさい。探してみたけど、「俺が欲しいものはなかった」と言う感じで、「単体テストをやるならここ少し踏ん張って書かねば」って言う気持ちになりました。
型に沿ってデータを生成するものはあったのですが、欲しかったのは、
- 用意したいデータは決まったカテゴリーの値しか含まれないSTRINGだったり、
- ゼロ以上の整数だけとか、
そう言う風にいい感じでBigQueryのスキーマにプラスαで指定したらいい感じでデータを生成してくれるものです。
カラム数が少ない場合とかはまぁ手動でもなんとかなりそうですが、そうじゃないと結構めんどくさいよなぁってなります。
壁②:クエリがテストしやすいように書かれていない
ここでは実行の速度とかは一旦無視して議論しますが、クエリのロジックがきちんと分かれておらず(with句で分けるとか、そもそもdatalake/dwh/datamartのレイヤーで分かれていないとか)、テストのために用意するデータが変に複雑化したり、見逃したりすることがあります。
先程のSAFE_CASTとかもそうですが、一番最初のデータを取得するレイヤーとかで型の変換処理をできる限りやっておくとか、その変換を分けておくとかだけでも、「どのようなデータが来ることを期待しているか」がわかりやすくなり、後に対処方法でも話す「データとクエリのテストを分ける」のが楽になります。
実際のクエリはそうなっていないことの方が多いので、まずは処理のフローが見通しよくする方から着手する感じになります。
壁③:クエリの変更にある程度テストの処理が耐えれるようにする
これは「壁②」の話にもつながるのですが、テストの処理の都合上、Composerなどで実際に処理の中で叩くテーブルとは違うものになります。
なので、プログラム上で変換をしてあげる必要があるわけなのですが、まぁパーティションテーブルだったりそうじゃなかったり、環境ごとに値が変わるようになっていたりとかするわけです。ここら辺きっちり耐えれるように、最初からクエリが書かれていればOKなのですが、そうじゃなかったりするので現実は大変です汗。
対処方法
ってなわけで、クエリの単体テストを書くときの壁を書いてきたのですが、それに対してどのような対処方法をしていくのが良さそうかを考えてみました。
①:そもそも入口をちゃんとする
元も子もない話ですが、後述する対処方法を考えると、「datalake」のレイヤーにくるデータがいい感じであればあるほど最高なわけです。
こんなケースの方が少ないと思うので、一旦ここまでにしておきますが、マジでこれが効いてくるんだなぁと言う気持ちです。
②:値をフィルターする処理とクエリの集計ロジックを分ける
異常値が入ってくる可能性があることを想定するのは良いことですが、それと集計ロジックをごっちゃにすると、テストをする上でうまく切り分けができなくなります。
なので、「値をフィルターする処理」と「クエリの集計ロジック」をできる限りテーブルであったり、同じクエリ内であったとしてもわかりやすく分けたりすることで、「集計ロジックに対してのテストはある程度期待されるデータのみとする」と言うようにできます*6。
以下で述べる有効範囲のテストとの切り分けも見通しが良くなり、ミスが防ぎやすくなります。
③:値の有効範囲のテストとクエリの集計のテストを分ける
これも当たり前だよって気持ちかもですが、値としては入ってくる可能性がゼロとは言えないケース(アプリケーションの仕様が変わった、ミスってデータを送ってしまった、等)はあるとして、「その値が来たことに気づくテスト」と「クエリの集計が正しいかのテスト」を分けることで、簡単になるケースがあります。
例えば、以下のようにテストを分けるとかです。
- 値の有効範囲のテスト:ユニーク制約、Enum型のチェックなど
- クエリの集計のテスト:ロジック部分にのみフォーカスを当てたチェック
この切り分けをすることで、クエリの集計のテストの部分では、さまざまな値がきたことを想定したテストをしなくて良くなり、データを用意する手間が省けます。
クエリの集計のテストだけでも大変ですが、ある程度正常系に落とし込むことができるので、これは現実的には有効な手段と思えます。
まとめ
ベストプラクティスはまだよく分かってませんが、もし知っていらっしゃる方とかいたら、ぜひ教えて欲しいです!
【Airflow】KubernetesPodOperatorにdag_run.confを渡したい
こんにちは。
今日は、airflowと戯れていたら、なんかバグを踏んだか何かをしたので、それについて書きたいと思います。
やりたいこと
KubernetesPodOperatorにdag_run.confをenv_varsのパラメーター経由で渡して、そのenv_varsに、実行日を渡して、どの日の実行を行いたいかを環境変数経由でdockerコンテナの方に伝えたいことが今回やりたいことです。
ここで、実行日をUIからTrigger Dagをしたときに渡すために、 dag_run.conf経由で渡したいとします。デフォルトでは実行した時刻です。
ハマったこと
airflow2.0を今Cloud Composer経由で使っているのですが、airflowのバージョン1と変わったようで、うまくtemplateが動いてくれませんでした。具体的には、最初以下のようなコードを書いていました。
kubernetes_pod_operator.KubernetesPodOperator(
        task_id='hogehoge_task_id',
        name='hogehoge_name',
        cmds=['run'],
        env_vars={'ENV': env, 'EXECUTE_DATE': '{{ dag_run.conf["ymd"] if dag_run.conf["ymd"] else ds }}'},
        secrets=[secret_volume],
        namespace='default',
        startup_timeout_seconds=60 * 30,
        is_delete_operator_pod=True,
        image_pull_policy='Always',
        image='hogehoge')
templated(jinjaのテンプレートを読み取って処理してくれる)なパラメーターなはずなのに何故か、これが文字列として渡されていて、日付データじゃないよ、みたいなエラーが出てしまっていました。なんでだろうと思って調査してたのですが、意外にハマってしまったので、備忘録を残そうと思った次第です。
調査したこと
直接的な原因はわからなかったのですが、KubernetesPodOperatorのクラスを見ると、env_varsを変換している部分のコードが以下のようにあり、
その変換の関数が、以下にあることがわかりました。
具体的には、以下のコードなのですが、ここを見ると、dictの時は k8s.V1EnvVarってやつにしていることがわかります。
def convert_env_vars(env_vars) -> List[k8s.V1EnvVar]:
    """
    Converts a dictionary into a list of env_vars
    :param env_vars:
    :return:
    """
    if isinstance(env_vars, dict):
        res = []
        for k, v in env_vars.items():
            res.append(k8s.V1EnvVar(name=k, value=v))
        return res
    elif isinstance(env_vars, list):
        return env_vars
    else:
        raise AirflowException(f"Expected dict or list, got {type(env_vars)}")
dictで渡すと、jinjaのテンプレートがうまく変換されずに、そのままk8s.V1EnvVarの方に変換されてしまっている様子でした。なので、list形式に最終的にしてあげる必要があるのですが、そこでk8s.V1EnvVarを使うと、それを文字列とみなしてしまうためダメでした。
仕方ないので、V1EnvVarの定義を見て、それの形になるように自分で渡してあげると、うまくいきました。
最終的なコード
ということで、以下のような感じで渡すとうまくいきました。
kubernetes_pod_operator.KubernetesPodOperator(
        task_id='hogehoge_task_id',
        name='hogehoge_name',
        cmds=['run'],
        env_vars=[
            {'name': 'ENV', 'value':'hogehoge'},
            {'name': 'EXECUTE_DATE', 'value': '{{ dag_run.conf["ymd"] if dag_run.conf["ymd"] else ds }}'}
        ],
        secrets=[secret_volume],
        namespace='default',
        startup_timeout_seconds=60 * 30,
        is_delete_operator_pod=True,
        image_pull_policy='Always',
        image='hogehoge'
)
んー、謎。。。
【Pandas】週の曜日の始まりが違う場合の週ごとの日付を取得する方法があったのでまとめる
こんにちは。
モチベーション
今開発で、週の曜日の始まりが違うケースがあって、でも一年間の週の通し番号ごとに集計をしたい、みたいな感じのことがしたく、週の曜日始まりが違う曜日のスタートで、週ごとの日付を取得したいなという気持ちがありました。
pandasで普通に週ごとの日付を取得したい場合は、date_rangeのメソッドを使って、
import pandas as pd

pd.date_range(start='2021-01-01', end='2022-01-01', freq='W')
とすればいいなって思っていました。が、この週の曜日のスタートを変えたい場合は、どうしたらいいんだろうというのを解消するのがこの記事のモチベーションです。
結論
freqのパラメーターに、良きパラメーターがありまして、それを追加するだけです。例えば、月曜日スタートにしたい場合は、以下のようになります。
import pandas as pd

pd.date_range(start='2021-01-01', end='2022-01-01', freq='W-MON')
簡単すぎる、、、。
他の曜日はどうするの
ということで、freqのパラメーターのリストを作りました。
| 開始曜日 | freqのパラメーター |
| 日曜日 | W-SUN |
| 月曜日 | W-MON |
| 火曜日 | W-TUE |
| 水曜日 | W-WED |
| 木曜日 | W-THU |
| 金曜日 | W-FRI |
| 土曜日 | W-SAT |
以下のサイトに公式のドキュメントがあります。
それでは。
【Python】Pandasでcross joinをする方法
こんにちは。
今日は、pandasでcross joinをする方法について書きたいと思います*1。
やりたいこと
df_a, df_bの二つのデータフレームがあったとして、その二つのデータフレームをcross joinしたいなという気持ちになったとします。
ただ、Pandasにはこれをそのままでやる方法がありません。
やり方
以下のような感じで実現できます。
def cross_join(df_a, df_b, common_key=None):
    if common_key is not None:
        return pd.merge(df_a, df_b, on=common_key, how='outer')

    df_a['tmp'] = 1
    df_b['tmp'] = 1

    return pd.merge(df_a, df_b, how='outer')

cross_join(df_a, df_b)
同じキーを用意してあげて、それをouterでjoinすることで実現できます。
まとめ
んー、なんか用意して欲しいなぁって思う笑。それでは。
*1:毎回調べちゃうので
自然言語処理向けのデータ作成ツールの「doccano」を使ってみたので、まとめる
こんにちは。
最近、仕事で自然言語処理関係のプロジェクトをやっているのですが、その関係でdoccanoというツールを触ってみることになったので、使い方とかをまとめておきます。
doccanoとは
doccanoとは、オープンソースのテキストアノテーションツールです。
以下の三つのアノテーションタスクをすることができます。
- Text Classification
- Sequence Labeling
- Sequence to Sequence
demoサイトは以下から。
RESTful APIなども搭載されているので、結果の取得をAPI経由で行うなどもすることができます。
doccanoをとりあえずローカルで立ち上げてみる
doccanoをローカルでとりあえず試してみます。
pipでインストールして立ち上げる
以下のコマンドだけで立ち上げることができます。
$ pip install doccano

$ doccano
これで、 http://0.0.0.0:8000/にアクセスするとツールを見れます。
簡単ですね。
dockerで立ち上げる
dockerで立ち上げるのもそう難しくなく、以下のコマンドで対応できます。
$ docker pull doccano/doccano
$ docker container create --name doccano \
  -e "ADMIN_USERNAME=admin" \
  -e "ADMIN_EMAIL=admin@example.com" \
  -e "ADMIN_PASSWORD=password" \
  -p 8000:8000 doccano/doccano

docker container start doccano
これで、 http://localhost:8000/にアクセスするとツールを見れます。
Sequence Labelingを試してみる
今回は、テキスト中の「偉い人」と「そうでない人」を識別するという意味不明なタスクを想定して、その表現部分をアノテーションしていくことをやってみようと思います。
ローカルで立ち上げてログインする
先ほどの方法でローカルで立ち上げます。ここから先は、AWSやGCPなどの環境で立ち上げても同じです。
ユーザー名とパスワードを入れます。
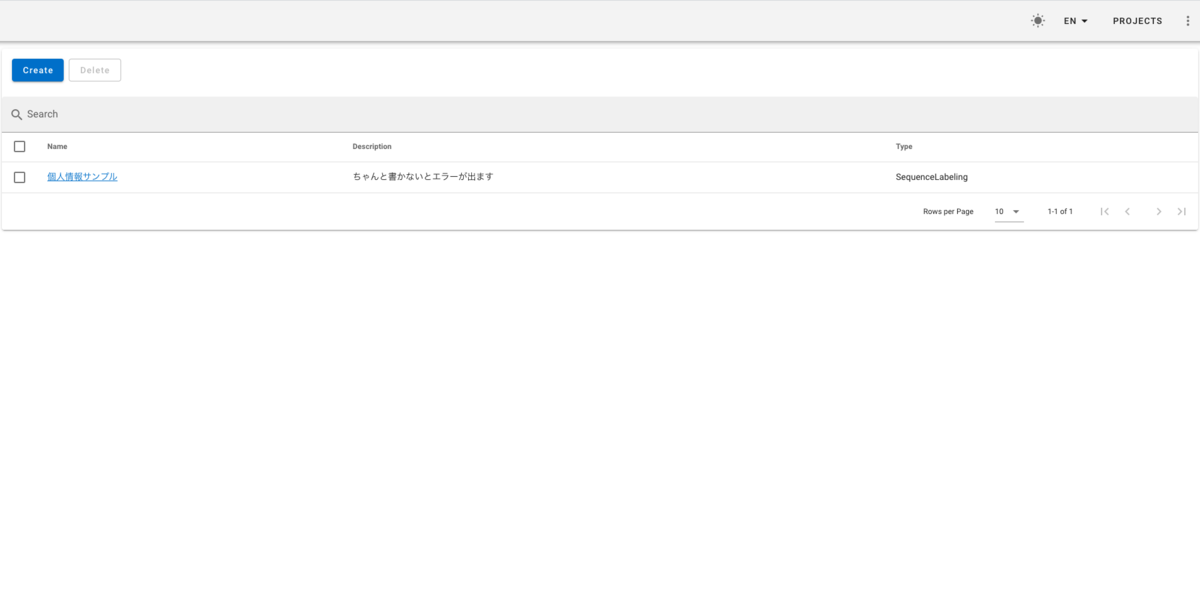
プロジェクトを作成する
入ると、プロジェクトの一覧を見ることができます。最初は、プロジェクトがないので、一覧には何もないですが、今回の私の例ですと、一つプロジェクトが作られています。
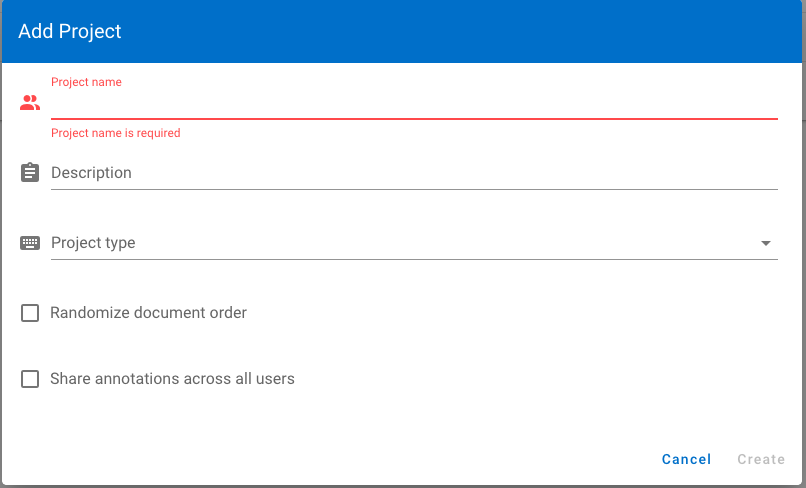
今回のアノテーションタスクに関するプロジェクトを立ち上げます。左上のCreateを押すと、以下のようなモーダルが出るので、それに入力します。
プロジェクトを作成して、プロジェクトのページに行くと、以下のような画面が見れます。
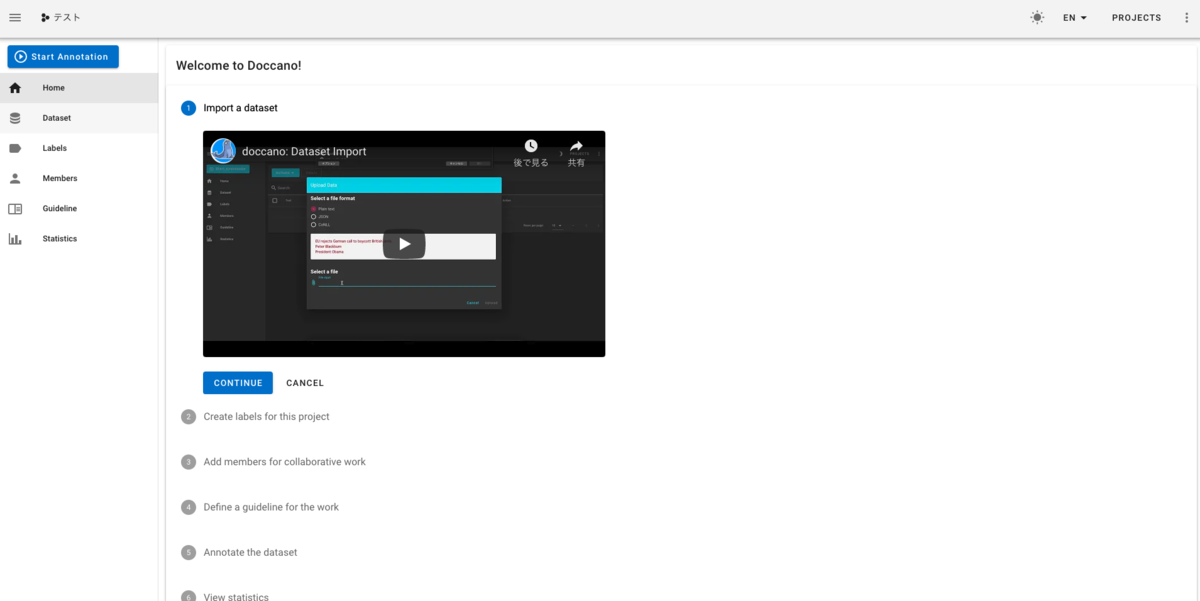
左側に、メニューがありますが、それぞれ以下の役割があります。
- Home:各ステップのやることがYoutubeの動画で学べる
- Dataset:AnnotationするデータをImport、Exportすることができ、またAnnotationをデータに対して行うことができる
- Labels:Annotationをするラベルを登録することができる
- Members:Annotationをするメンバーの一覧を確認できる
- Guideline:Annotationのガイドラインをここに記載することができる
- Statistics:Annotationの実施状況を確認することができる
データセットのインポート
早速、データセットのインポートをしてみます。サイドメニューからインポートをします。
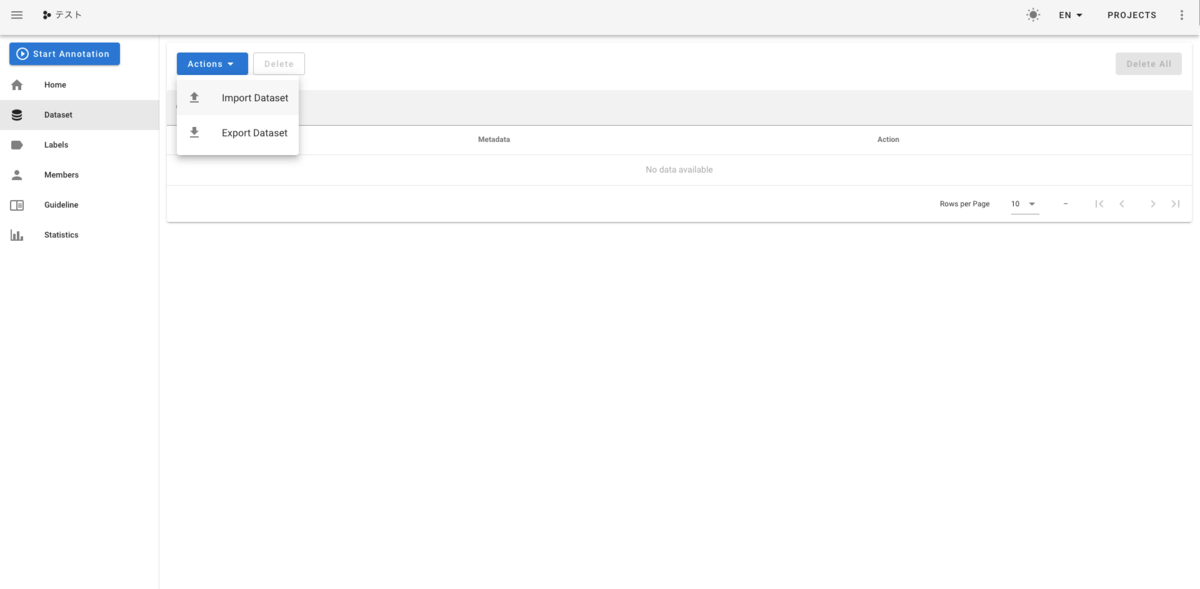
以下のようなモーダルが出てくるので、お好きな方法でデータをインポートします。
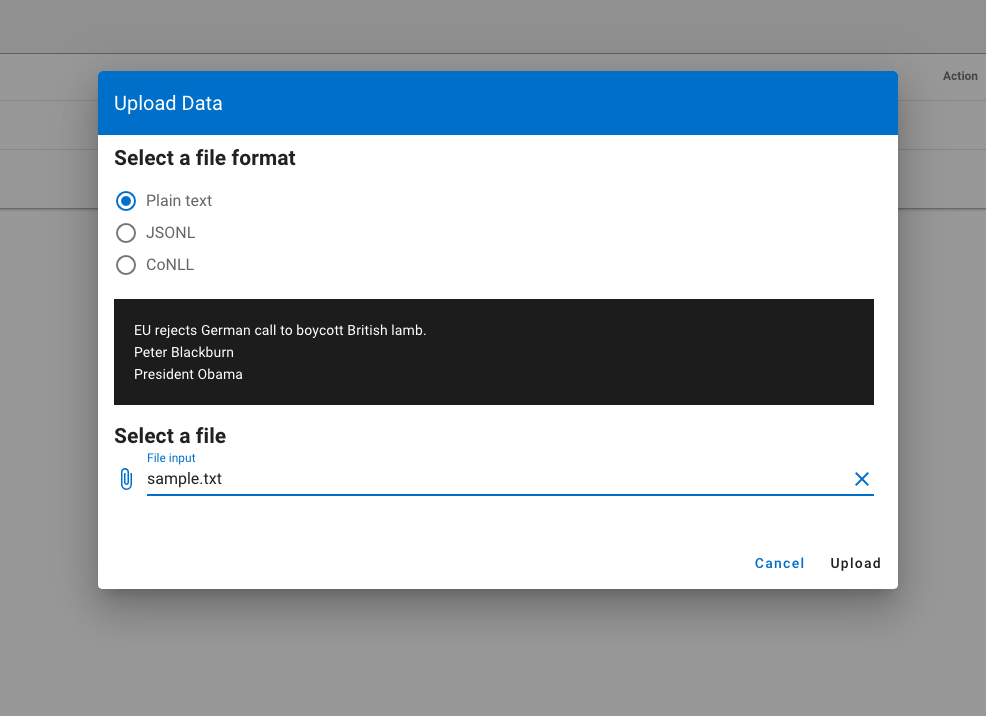
Createと押すと、データの取り込みが行われます。
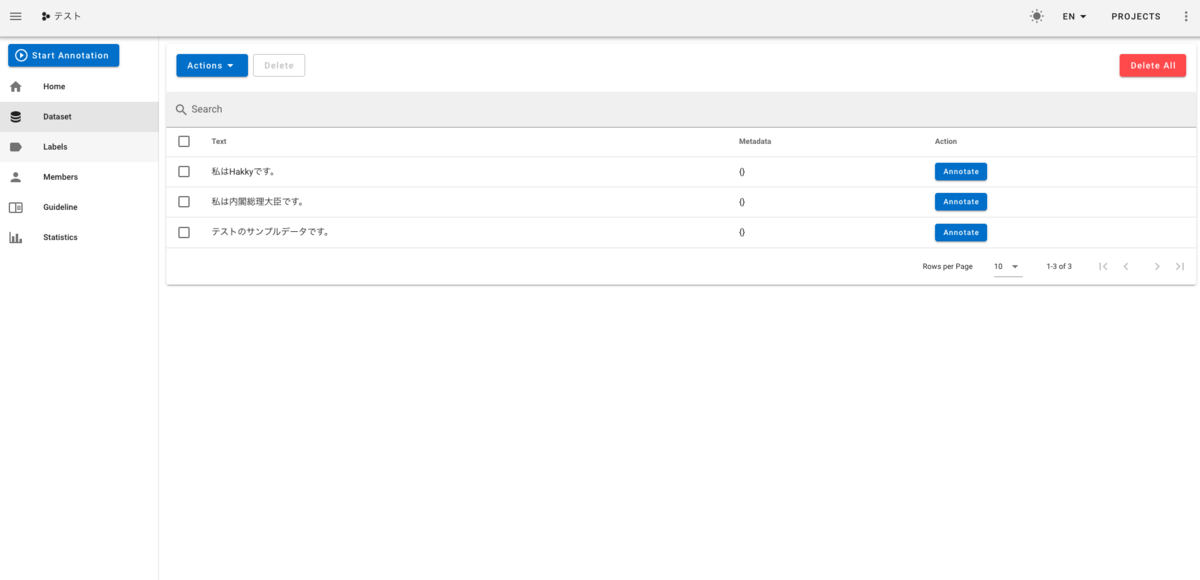
ラベルを作成する
今回のアノテーションでつけるラベルを作成します。
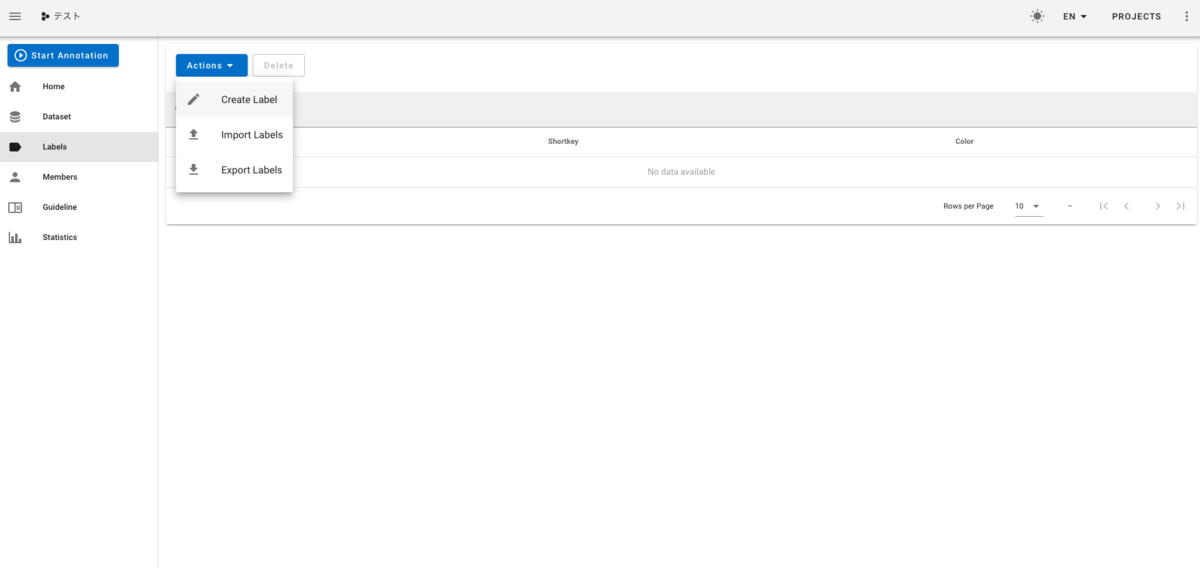
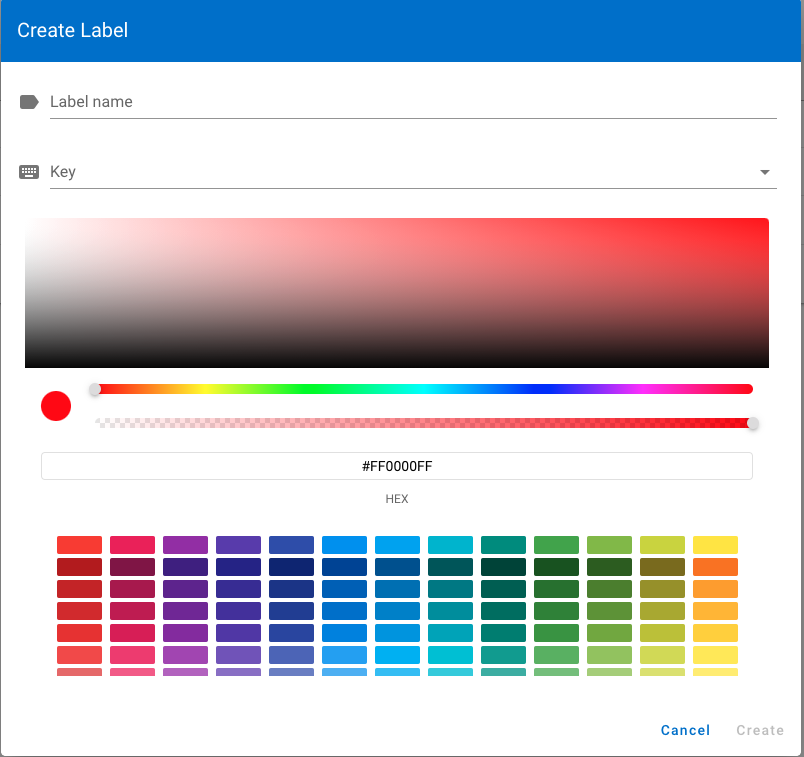
Createを押すと、以下のようなモーダルが表示され、必要な情報を記入します。
今回は、偉い人とそうじゃない人を当てるタスクを解きたいので、以下のようなラベルを作成しました。
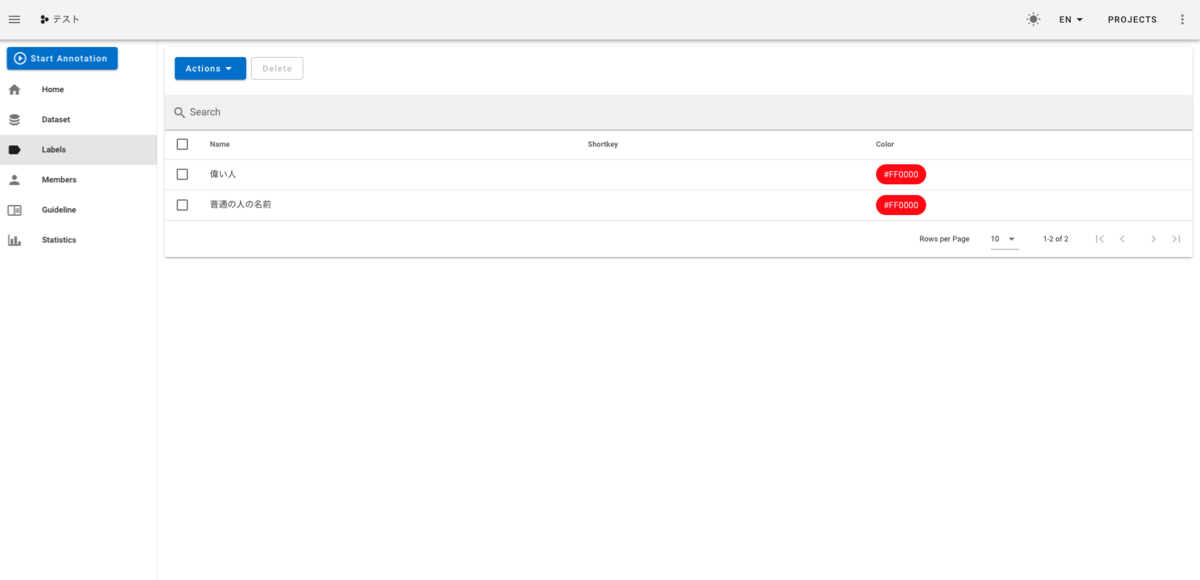
これで準備完了です。あとはひたすらアノテーションをするだけです。
Annotatonを開始する
左上の「Start Annotation」からでもいいですし、以下の画像にあるようにDatasetの一覧からAnnotationしたいものからスタートしてもいいですし、なんでも大丈夫です。
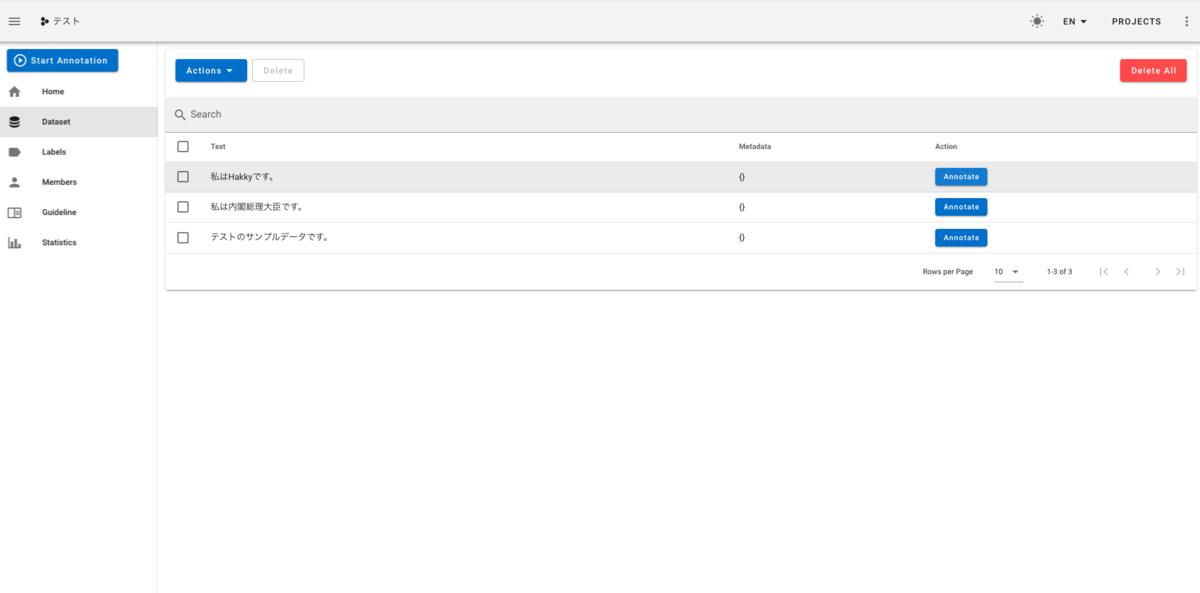
Annotationをスタートさせると、以下のようにテキストが出てきます。マウスでテキストを洗濯すると、先ほど作成したラベルが表示され、どのラベルにするかを選択することができます。
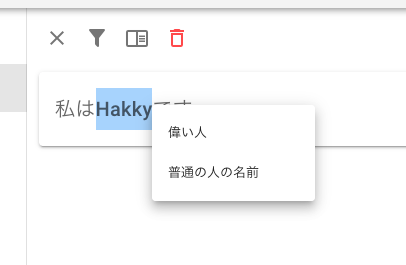
選択すると、以下のようにラベルがテキストに対して付与されます。
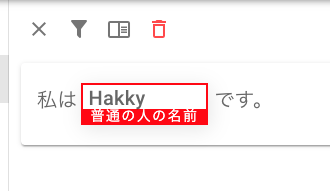
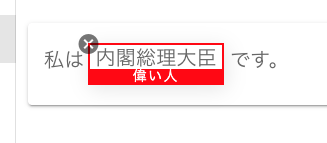
そして、以下のようにラベルを付与した後に間違えたと思ったらバツボタンを押すことで、消すこともできます。
Annotationの実施状況を確認する
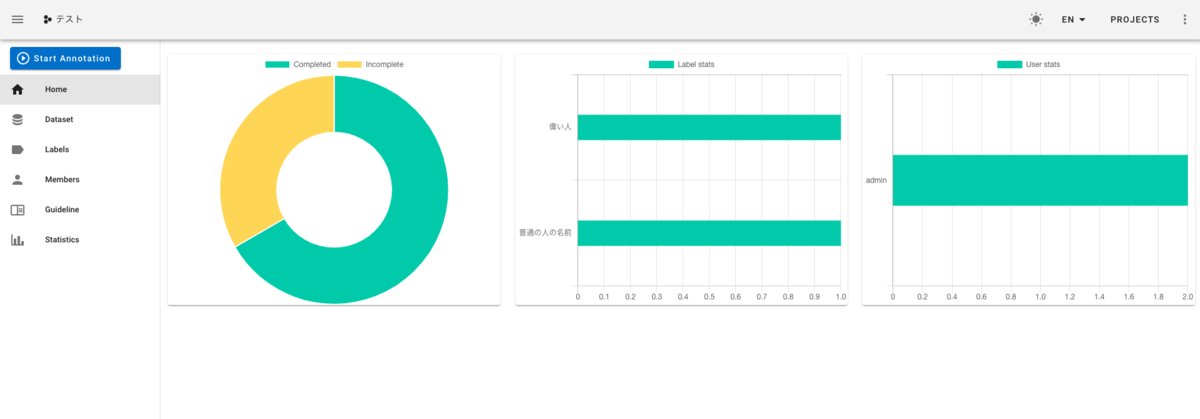
Annotationをこのように行っていくのですが、実施した状況については、以下のように統計情報として得ることができます。便利ですね。
Annotationした結果を受け取る
Annotationが終わったら、データをExportすることができます。以下の画面から、Exportを選択して、
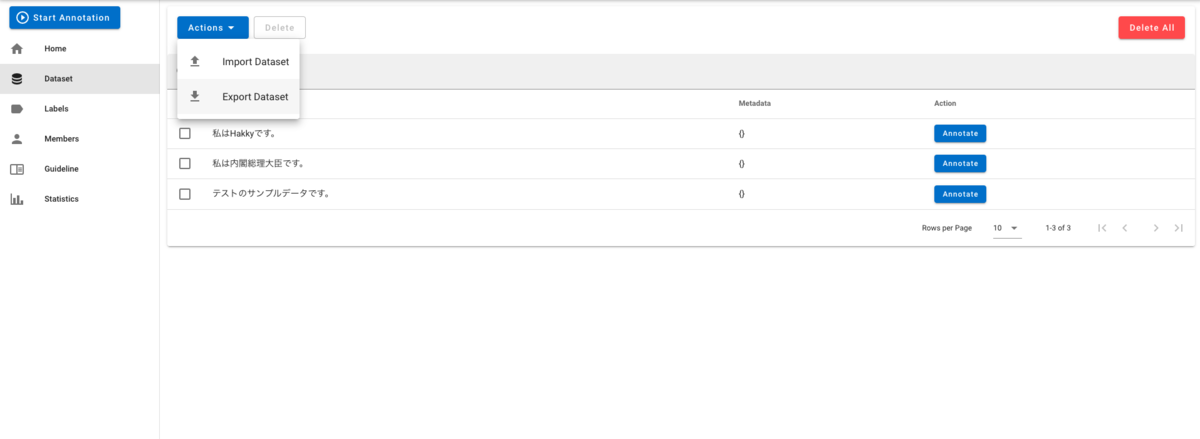
モーダルに必要な情報を入力するとExportできます。
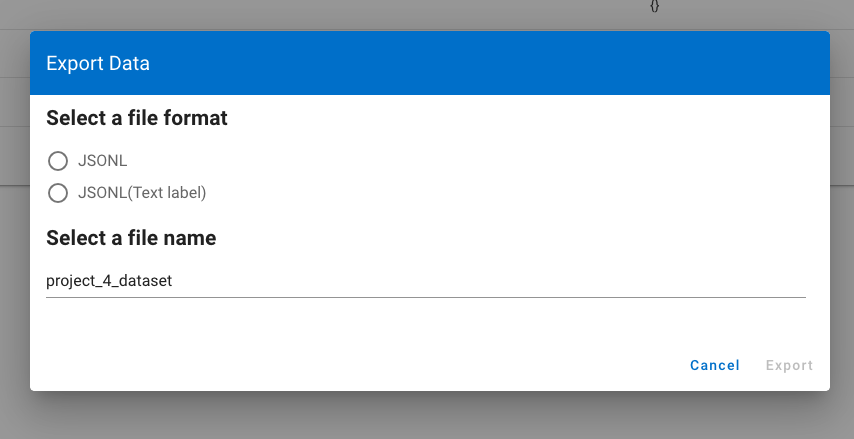
以上で一通りの機能については紹介しました。
感想・まとめ
今回のブログで紹介した以外にも、ショートカットキーで操作ができたり、他にも機能としてはいくつかありそう。
ただ、
- 1プロジェクトにつき1MBまでしかデータがImportできないっぽい…?
- Sequence Labelingでラベル付与しなかったものを完了ってするのどうするんだろうという気持ち
というような感じで、ちょいちょいどうしたらいいんだろうっていうところはあったので、使いながら確認して行こうかなーと思っています。
それでは。
【kedro】gcsのファイルを読み込むときのcredentialsの設定方法
こんにちは。
kedroのドキュメントにもし書いてあったらすみませんなのですが、地味にハマったので、備忘録的に書いておきます。
やりたいこと
gcsにあるデータを読み込んで、それを処理のなかで使いたいです。
設定方法
credentials系の情報は、 conf/local/credentials.yamlに設定すると思うのですが、そこに以下のように書きます。
my_gcp_credentials:
  token: conf/local/my-service-account.json
このtokenと言うキーとdictにファイルを指定すること、そのファイルパスの指定方法は、いつも通りproject配下がルートで、そこからのパスと言う感じです。
なかなか出てこなくてkedroのコード読んで雰囲気でやってみたら出来たので、書いておきました*1。
*1:みんなGCSからデータを読み込めるよってことは書いてあるのに笑
【 Kedro】Kedroに入門したのでまとめる
こんにちは。
最近、Kedroと言う機械学習向けのパイプライン構築用のツールを使ってみたので、それについてまとめます。
Kedroとは?
概要
Kedro は QuantumBlack というデータ分析企業 が公開している、プロダクションレディなデータ分析用ワークフロー構築ツールです。結構いろんなパイプラインツールがありますし、全部を触ったことがあるわけではないですが、今のところ*1Kedroはすごくすごく良い感じです。
ツールの紹介動画は以下*2。
公式周りのサイトのURLは以下の通り。
特徴
めちゃめちゃたくさんの特徴がありますが、以下あたりはすごく便利です。
- Airflowなどと同じく、Pythonで全てのワークフローを書くことができる
- DAG形式でパイプラインを定義でき、 Sequentialな実行とParallelな実行の切り替えや、パイプラインの途中から実行するなどできる
- yamlで定義することができるデータカタログの機能があり、csv, pickle, feather, parquet, DB上のテーブル など様々なデータ形式に対応することができる
- データセットや学習モデルをバージョン管理し、指定のバージョンでいつでも実行できるよう再現性を担保する
- Cookiecutter によるテンプレートを利用することで、複数人での作業を管理できる
- モデルのパラメーターをyamlで管理することができる
- Jupyter Notebook, Jupyter Lab とのインテグレーション
- 本番環境への移行がしやすく、複数の環境(AWS, GCPのようなマネージドサービスなど)にデプロイすることができる。具体的にはPythonのパッケージとしてであったり、kubeflowやArgo Workflows、AWS Batchにデプロイなどもできる
- リッチなパイプラインの可視化がKedro vizでできる
とりあえずやりたいことは一通りできそうな雰囲気を感じ取っていただけると思います笑
Kedroの大まかな構成要素
Kedroは、大まかには次の4つから構成されています。
- Node
- Pipeline
- DataCatalog
- Runner
Node
- 実行される処理の単位で、前処理や学習といった処理本体になるもの
- 入力、出力のデータセットと、それを処理するロジックを定義して、パイプラインに組み込む
Pipeline
- Nodeの依存関係や実行順序を管理するもの。
- decorator機能がkedroにはあり、これによって、パイプライン全体の処理に対して機能を付加することもできる
DataCatalog
- パイプラインで使用するデータを定義するカタログ
- データセット名、形式、ファイルパス、ロードやセーブ時のオプションなどを指定することが可能
Runner
- パイプラインを実行するもの。パラメーターを指定して実行することができ、例えば特定のパイプラインだけ実行するとかもできる。
- SequentialRunner、ParallelRunnerの二つのRunnerがある。
Install
普通にpipとかcondaでインストールできます。
# pipとかcondaでインストールできます
$ pip install kedro
$ conda install -c conda-forge kedro

 # installされたかの確認。kedroっていう文字が出てきたら成功
$ kedro info

 _            _
| | _____  __| |_ __ ___
| |/ / _ \/ _` | '__/ _ \
|   <  __/ (_| | | | (_) |
|_|\_\___|\__,_|_|  \___/
v0.16.6

kedro allows teams to create analytics
projects. It is developed as part of
the Kedro initiative at QuantumBlack.

No plugins installed
新規のプロジェクトを作成する
kedroのデフォルトのテンプレートを使う場合は、以下のコマンドでやります。いくつか質問が出てきますが、それぞれ読んで答えればオッケー。
$ kedro new
テンプレートをオンにすると、以下のような感じでフォルダが構成されます。
$ tree .

.
├── README.md
├── conf
│   ├── README.md
│   ├── base
│   │   ├── catalog.yml
│   │   ├── credentials.yml
│   │   ├── logging.yml
│   │   └── parameters.yml
│   └── local
├── data
│   ├── 01_raw
│   │   └── iris.csv
│   ├── 02_intermediate
│   ├── 03_primary
│   ├── 04_feature
│   ├── 05_model_input
│   ├── 06_models
│   ├── 07_model_output
│   └── 08_reporting
├── docs
│   └── source
│       ├── conf.py
│       └── index.rst
├── kedro_cli.py
├── logs
│   └── journals
├── notebooks
├── setup.cfg
└── src
    ├── requirements.txt
    ├── sample
    │   ├── __init__.py
    │   ├── hooks.py
    │   ├── pipelines
    │   │   ├── __init__.py
    │   │   ├── data_engineering
    │   │   │   ├── README.md
    │   │   │   ├── __init__.py
    │   │   │   ├── nodes.py
    │   │   │   └── pipeline.py
    │   │   └── data_science
    │   │       ├── README.md
    │   │       ├── __init__.py
    │   │       ├── nodes.py
    │   │       └── pipeline.py
    │   └── run.py
    ├── setup.py
    └── tests
        ├── __init__.py
        ├── pipelines
        │   └── __init__.py
        └── test_run.py
プロジェクトをgitの管理下にするには、以下のような感じでやります。
$ git init
$ git add ./
$ git commit -m "init"
$ git branch -M main
$ git remote add origin <hogehoge>
$ git push origin main
フォルダ構成からわかると思いますが、どこに何を書くかが明確で、サンプルのコードを追いかけるだけで、大体何すればいいかわかります笑*3
とりあえず動かしてみる
kedro newをしたときに、irisのデータセットでサンプルのモデルを動かすためのパイプラインやノード、データカタログが用意されているので、とりあえずこいつをローカルで動かしてみたいと思います。
$ cd <プロジェクトルート>

# まずはプロジェクトの依存関係をインストール
$ kedro install

# 実行
$ kedro run
これだけです。簡単ですね。実行すると、logのフォルダにログが吐き出されるのがわかります。
次からは、処理を実際に追加していくのをどうするか見ていきます。
データソースを追加する(Data Catalogを追加する)
Nodeなどでデータを実際に使うために、データカタログにデータソースを追加します。conf/base/catalog.ymlというファイルに記述していきます。
csvとかであれば、以下のような感じで追加できます。他にも、xlsxやparquet, sqlTableなど様々なデータソースに対応できます。
companies:
  type: pandas.CSVDataSet
  filepath: data/01_raw/companies.csv

reviews:
  type: pandas.CSVDataSet
  filepath: data/01_raw/reviews.csv
dataのディレクトリに、それぞれのデータの状態に合わせてフォルダにデータを入れます。ここら辺も人によってフォルダの分け方が別れることがほとんどですが、事前に定義がされているのでやりやすいです。
処理を追加する(Nodeを編集する)
nodeの処理は単純で、普通に関数を追加するだけです(完)
試しに、テンプレートで出てくるnodes.pyの処理を見て見ます。
from typing import Any, Dict

import pandas as pd


def split_data(data: pd.DataFrame, example_test_data_ratio: float) -> Dict[str, Any]:
    """Node for splitting the classical Iris data set into training and test
    sets, each split into features and labels.
    The split ratio parameter is taken from conf/project/parameters.yml.
    The data and the parameters will be loaded and provided to your function
    automatically when the pipeline is executed and it is time to run this node.
    """
    data.columns = [
        "sepal_length",
        "sepal_width",
        "petal_length",
        "petal_width",
        "target",
    ]
    classes = sorted(data["target"].unique())
    # One-hot encoding for the target variable
    data = pd.get_dummies(data, columns=["target"], prefix="", prefix_sep="")

    # Shuffle all the data
    data = data.sample(frac=1).reset_index(drop=True)

    # Split to training and testing data
    n = data.shape[0]
    n_test = int(n * example_test_data_ratio)
    training_data = data.iloc[n_test:, :].reset_index(drop=True)
    test_data = data.iloc[:n_test, :].reset_index(drop=True)

    # Split the data to features and labels
    train_data_x = training_data.loc[:, "sepal_length":"petal_width"]
    train_data_y = training_data[classes]
    test_data_x = test_data.loc[:, "sepal_length":"petal_width"]
    test_data_y = test_data[classes]

    # When returning many variables, it is a good practice to give them names:
    return dict(
        train_x=train_data_x,
        train_y=train_data_y,
        test_x=test_data_x,
        test_y=test_data_y,
    )
この後出てくるパイプラインとデータの入出力を合わせる必要がありますが、それ以外は普通の関数の処理であることがわかると思います。書く場所をある程度縛るだけで、ここら辺に特にルールがないのは助かりますね。
パイプラインを編集する
パイプラインの処理で編集するのは二箇所で、pipeline.pyとhooks.pyの二つです。
pipeline.py
まずpipeline.pyですが、自分で実装したnodeの関数を、kedro.pipeline.nodeを使って、パイプラインに組み込みます。組み込むときには、第一引数に関数、第二引数に入力で渡すデータ、第三引数に出力のデータを渡します。
from kedro.pipeline import Pipeline, node

from .nodes import split_data


def create_pipeline(**kwargs):
    return Pipeline(
        [
            node(
                split_data,
                ["example_iris_data", "params:example_test_data_ratio"],
                dict(
                    train_x="example_train_x",
                    train_y="example_train_y",
                    test_x="example_test_x",
                    test_y="example_test_y",
                ),
            )
        ]
    )
これだけです。
hooks.py
pipeline.pyで作ったパイプラインを実行できるようにします。また、パイプライン間に依存関係がある場合がほとんどだと思いますので、その処理も書きます。
from typing import Any, Dict, Iterable, Optional

from kedro.config import ConfigLoader
from kedro.framework.hooks import hook_impl
from kedro.io import DataCatalog
from kedro.pipeline import Pipeline
from kedro.versioning import Journal

from ab_recommender.pipelines import data_engineering as de
from ab_recommender.pipelines import data_science as ds


class ProjectHooks:
    @hook_impl
    def register_pipelines(self) -> Dict[str, Pipeline]:
        """Register the project's pipeline.

        Returns:
            A mapping from a pipeline name to a ``Pipeline`` object.

        """
        data_engineering_pipeline = de.create_pipeline()
        data_science_pipeline = ds.create_pipeline()

        return {
            "de": data_engineering_pipeline,
            "ds": data_science_pipeline,
            "__default__": data_engineering_pipeline + data_science_pipeline,
        }

    @hook_impl
    def register_config_loader(self, conf_paths: Iterable[str]) -> ConfigLoader:
        return ConfigLoader(conf_paths)

    @hook_impl
    def register_catalog(
        self,
        catalog: Optional[Dict[str, Dict[str, Any]]],
        credentials: Dict[str, Dict[str, Any]],
        load_versions: Dict[str, str],
        save_version: str,
        journal: Journal,
    ) -> DataCatalog:
        return DataCatalog.from_config(
            catalog, credentials, load_versions, save_version, journal
        )


project_hooks = ProjectHooks()
これだけで、実行順序の依存関係を記述することができます。
まとめ
以上がざっくりとしたkedroの使い方です。まだ試せていないのですが、kedroのフレームに則って書いておけば、AWS Batchやkubeflowなどにデプロイすることができるようになるなど、他にも良さげな感じの物が多いので、使ってみたいと思います。
それでは!
参考
【AWS】AWS Data PipelineのstartDateTimeの指定で盛大にハマった話
こんにちは。
今日は、AWS Data Pipelineを使っていてstartDateTimeの指定で盛大にハマったので、その話を書きます。
そもそもAWS Data Pipelineって何?
って方は、以下の記事をどうぞ。まぁ、この記事読んでいる人はこれについては知っているだろうけど。
今日話すこと以外にもハマりポイントは数知れずなので、それも供養。
前提
現在dev環境とprod環境の二つを用意していて、そこで同じパイプラインの内容を動かしているのですが、devでテストをしてprodにリリースをしました。
devでリリースした日とprodでリリースした日は違いますが、pipelineの定義などは全部一緒です。
このリリースした日が違うというのがポイントです。
ハマったこと
prodにリリースをして、数日がたったある日「くっ、なんかデータ起因のエラーが出ている」ということでそこを直す対処をしました。
で、これをdevでテストして、さぁprodでリリースするぞということで、cli経由(正確にはCIでリリース)でprodにリリースしました。
そしたら、次のようなエラーが出たわけです。
{
    "validationErrors": [
        {
            "errors": [
                "startDateTime can not be changed"
            ],
            "id": "DefaultSchedule"
        }
    ],
    "errored": true
}
「ん?startDateTimeなんか俺変えてないんだけど」
ってなったんですよ。ちなみに、該当となるjsonは以下。
{
  "period": "1 days",
  "startDateTime": "2020-10-20T21:30:00",
  "name": "Every 1 day",
  "id": "DefaultSchedule",
  "type": "Schedule"
}
で、「んー?」みたいな感じで悩んでいたんですけど、何回コンソール、コードのdiffを見ても同じ時間なんですよ。同じコードになっているdevでリリースしてもエラーは出ない。
で、一個思いついたのが、devでリリースリリースした日とprodでリリースした日が違うなぁっていうのがあったんですね。
まさかなって思って、prodでリリースして最初に実行した時間をpipelineに指定してやってみたら、今度はうまくいきました。
ということで知見
以下、供養する知見です。
- aws data pipelineでは、どうやら最初にaws datapipelineの中身をリリースしたときに、過去の日付を最初の実行開始日時と指定した場合、なんか内部的には最初にスケジュールを実行した日時になるらしい
- なので、aws data pipeline上で、パイプラインを定義しているjsonが、「yyyymmddのhh時mm分に実行しますよ」って書かれていて、そうやってAWS Data pipelineのexport pipeline definitionやコンソール上の値が言っていても、最初の実行時刻isいつを見て、デプロイしないといけない
- 実際に、リリース作業をした次の日の実行時刻を試しにテストしてみたら、できた
これは完全に罠だったので、誰かの役に立たないかもだけど、書いておきます。
それでは。
【GCP】Serverless frameworkを使ってCloud Functionを作る
こんにちは。
最近、Serverless Frameworkを使ってCloud functionを作る機会があったので、そちらについてまとめておきます。
Serverless Frameworkとは
ServerlessアプリケーションであるLambdaやCloud Functionを構成管理したりデプロイしたり、ローカルで試したりするためのツールです。
以下、公式サイト。多少できることが最新の物に対して足りなかったりしますが、メインの使い所に対しては、問題なく機能があるので、ドキュメント読んでやりたいことができるかを確認しておくほうが良きかなと思います。
学習コストも少なく対応することができるので、おすすめです。
使う前の準備
serverless frameworkは、node.jsで書かれています。なので、nodeをインストールしておきましょう。
個人的におすすめなのは、nvmでnodeのバージョンを管理しておくこと。以下は、Centosに入れたときのブログですが、macとかでもほとんど同じなので、参考になるかなと。
インストール
これでインストールすることができます。
# servelessのインストール
$ npm install -g serverless

# インストールの確認
$ serverless --version
使ってみる
やること
実際にデプロイまではしませんが、以下のコマンドを紹介。
- GCPのcloud functionを、pythonのruntimeで実行するためのtemplateを作成する
- deployをする
やってみる
templateとなるファイルを作成するには、以下のコマンドを打つことで対応できます。
$ serverless create --template google-python
このコマンドを打つと、次の4つのファイルが生成されます。
- .gitignore
- main.py
- package.json
- serverless.yml
あとは、ここのmain.pyに自分が書きたい関数を書いたり、serverless.ymlにfunctionの設定を書き足していくような感じで書くことができます。
依存関係をインストールするために、以下のコマンドをインストールします。
$ npm install
変更箇所を変更したら、deployは以下の通り。
$ serverless deploy
これだけで出来ちゃいます。簡単ですね。細かい設定などは、マニュアル見ながらやればできちゃうので、ここでは割愛します。
注意点
これをやるときの注意点ですが、事前にdeployment managerのAPIを有効化しておく必要があります。また、Service Accountを取得する必要があるなどの点も留意事項です。
【AWS】AWS Data Pipelineでプライベートサブネット内にあるDB(RDS)を操作するのに盛大にハマったのでまとめる
こんにちは。
今日は、Data Pipelineでプライベートサブネット内にあるDBを操作する場合の対処方法についてはまったので、書いてみたいと思います。
はまったこと
この記事を書こうと思った動機にもなるのですが、AWS Data PipelineでEC2インスタンスを実行環境に指定して、Activityを動かそうとしていたのですが、その際にとあるVPC内のプライベートサブネット上にあるDBを操作する必要がありました。その時に、データベースにアクセスできないどころから、AWS Data pipelineのAPIを利用できないというエラーが出てしまいました。
よくよく考えたら当たり前っちゃ当たり前のことをしないといけなかったんですが、エラー内容などが出ておらず、「ん?なんで動かないの?」ってなって、数時間「んー」って悩んでしまったのでここに備忘録として残します。
つまりやりたいこと
つまりやりたいことをまとめると、以下のような感じになります。通常のWebアプリケーションなどの場合、マルチAZの構成にすると思いますが、ここではシンプルにするために一つだけ書いてます。
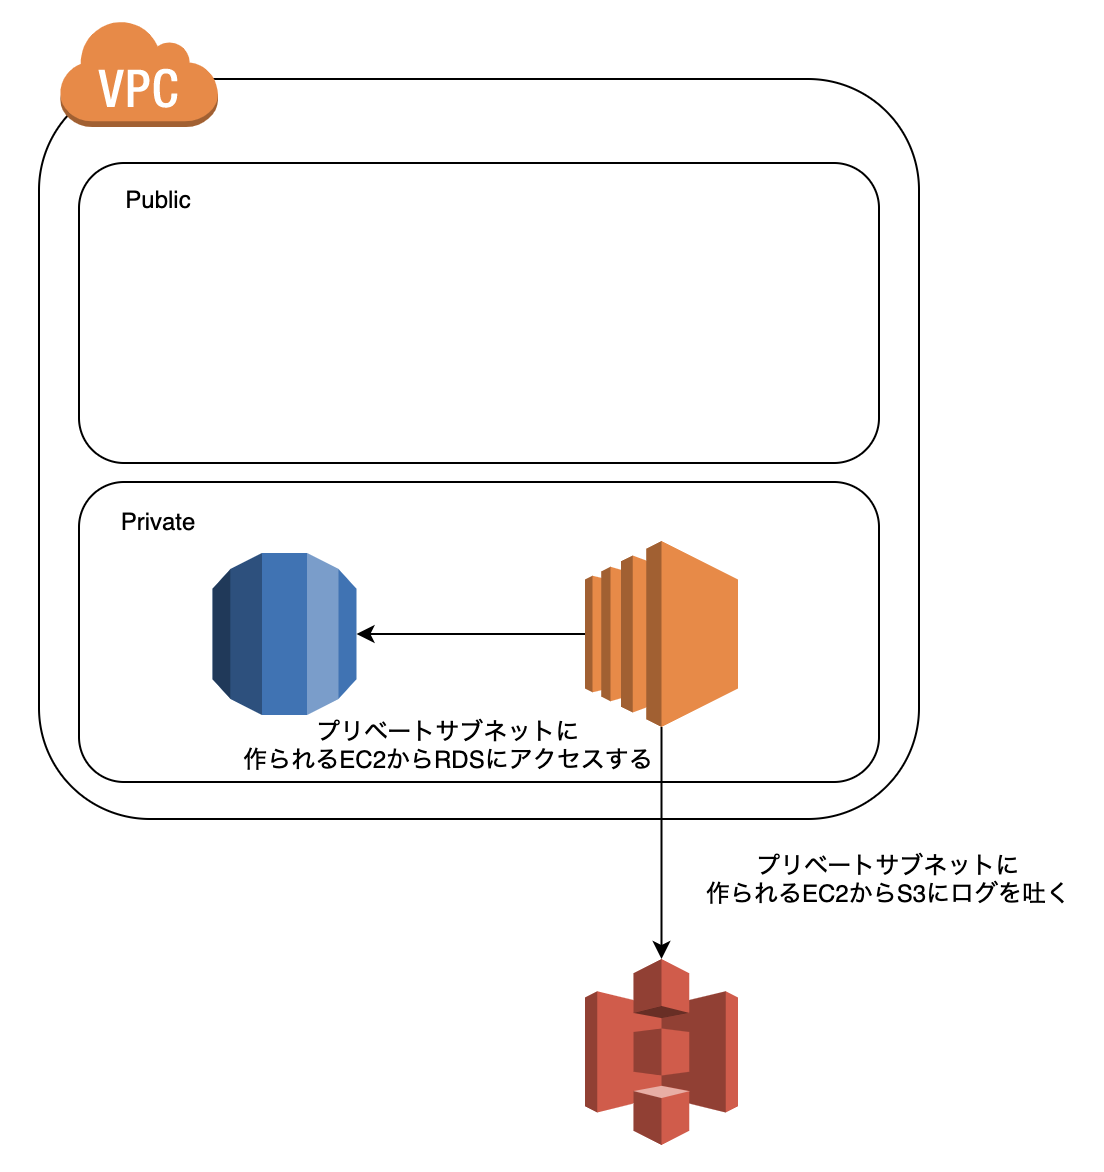
図中のEC2インスタンスは、Data Pipelineの実行環境として、Data Pipelineが作ったものとしてみてください。このEC2インスタスから、プライベートサブネットにあるDBにアクセスできるようにしたかった感じです。ちなみに、このDBはRDS(Aurora)です。
このケースに起きて起こっていた問題
このケースで起こっていた問題はいくつかありまして、以下の5つがうまくいかないと動きません汗。
- ①:ログやデータを吐き出すS3にEC2インスタンスがアクセスできる
- ②:EC2インスタンスから外部のネットワークにアクセスできる
- ③:EC2インスタンスからRDSにアクセスできる
- ④:DriverをAurora用に指定する
- ⑤:実行に必要なロールがアタッチされている
まぁ普通に図を書きながら、「EC2がここに配置されて〜」って考えれば当たり前だったのですが、Data Pipelineがよしなにやるのかなと思ってしまった部分をなかなか抜け出せず、時間を食ってしまいました。
今回の問題への解決策
それぞれの問題に対する解決策を書いていきます。
①:ログやデータを吐き出すS3にEC2インスタンスがアクセスできるようにする
今回は、プライベートサブネットからS3にアクセスできる必要があります。これについては、以下の記事であるように、VPC endpointのサービスを使いました。
これの設定自体はそこまで難しくなかったので手順通り行うことでできました。
②:EC2インスタンスから外部のネットワークにアクセスできる
ECSを動かそうとした時に、ECRにアクセスできなくてImageをプルできないみたいなエラーが出るのは経験したことがあるんですが、それと似たようなことでした。
具体的には、以下のようにEC2のインスタンスからdatapipelineのAPIを使おうとしたら、443のタイムアウトエラーが起こるというようなことです。
private.com.amazonaws.http.AmazonHttpClient: Unable to execute HTTP request: Connect to datapipeline.ap-northeast-1.amazonaws.com:443 timed out
このように、Data Pipelineを動かす時に、AWSのData PipelineのAPIをEC2インスタンスから使えるようにする必要があるみたいで、これをできるように設定する必要があります。これについては、NAT Gatewayを使ってプライベートサブネットにあるEC2インスタンスから外のインターネットにアクセスできるようにしました。
これについては、以下の記事をベースにやったらうまくいきました。
EC2のセキュリティグループのOutboundもここで全てのトラフィックを許可して、APIとかを使う際に外に出られるようにしました。
③:EC2インスタンスからRDSにアクセスできる
これについては、同じプライベートサブネットにあるEC2からRDSにアクセスできるようにすればいいだけなので、RDSのセキュリティグループのInboundの設定に、EC2のセキュリティグループを許可してあげれば解決します*2。
④:DriverをAurora用に指定する
何も考えずに、RDSのテーブルにアクセスしようとすると、以下のようなエラーが起こります。
DriverClass not found for database:aurora
このエラーの対処方法については、以下の記事に助けられました。
Auroraの場合は、ちょっとハマりポイントがあって、以下の記事に助けられました。
⑤:実行に必要なロールがアタッチされている
Data Pipelineを使う際には、デフォルトでDataPipelineDefaultRoleとDataPipelineDefaultResourceRoleの二つのロールが使われます。それぞれの役割は、次の通りです。
- DataPipelineDefaultRole:AWS Data Pipeline に AWS リソースへのアクセスを許可する
- DataPipelineDefaultResourceRole:アプリケーションに AWS リソースへのアクセスを付与する
このそれぞれのロールに、今回使うにあたって必要なロールをアタッチする必要があります。以下のマニュアルに書いてある通りに設定すれば基本的には大丈夫です。
ただし、私はなぜか自分でロールとポリシーをマニュアルで作成して、そのロールを使うように指定したら、以下のようなWarningが出ました。なので、デフォルトで用意されているロールを使うようにしました。
WARNING: 0 policies attached to the role - unable to validate policy for 'DataPipelineDefaultRole' as exactly one policy is expected when default policy is missing.

WARNING: 0 policies attached to the role - unable to validate policy for 'DataPipelineDefaultResourceRole' as exactly one policy is expected when default policy is missing.
その他:実行できるようになってもWarningが出続ける
ぶっちゃけ、ちゃんとロールを設定しても、以下のエラーが私は出続けました。基本的にはWarningを潰してからData PipelineをActivateする必要があるのですが、以下のWarningは無視しても実行できましたorz。
WARNING: Could not validate S3 Access for role. Please ensure role ('DataPipelineDefaultRole') has s3:Get*, s3:List*, s3:Put* and sts:AssumeRole permissions for DataPipeline.色々ググっていると、似たようなことに困っているforumやstackoverflowに出会いますが、解決されていないものばかり。。。
この件については諦めていますが、誰かナレッジがある方がいれば教えてください、、、。
まとめ
ここまでのまとめが以下です。
- AWS Data Pipelineで作られるEC2インスタンスの扱いは、普通のEC2インスタンスと同じなので、設定の確認などは、同じプライベートサブネット上に同じセキュリティグループでEC2のインスタンスを立てて一通り処理ができるかを確認する。誰(自分が作るか、AWS Data Pipelineのどちらか)が作るかの違いでしかない。
考えてみればワークフローやジョブの実行状態を管理するのがData Pipelineのメインのタスクなので、実行環境であるEC2の設定などはほかと同様にしないといけなかったという感じでした。
以上です。それでは。
【AWS】AWS Data Pipeline入門
こんにちは。
最近仕事でAWS Data Pipelineを使う機会があったので、その機能についてまとめます。
AWS Data Pipelineとは
AWS Data Pipelineとは、一言で言うとAWSが提供するAirflow、みたいな感じになると思います。
AWSのS3やDynamoDB、Redshiftなどといった代表的なデータソースとも連携ができ、cronのようなジョブスケジューリング機能や、ジョブの依存関係や実行環境の定義、ジョブの実行のためのリソース(EC2・EMR)の起動と停止、コンソール上から処理実行のStatusの確認・リトライができます*1。
もちろんフルマネージドなので、cronの監視みたいな、「ジョブの監視の監視」みたいなこともしなくていいです。笑
典型的なユースケースに対しては、すぐに試せるようにTemplateも用意されていて、例えばRDSからS3にデータをコピーしたい場合などは、いくつかの設定をするだけで、実現することができます。
利用シーン(Airflowとかとの違い)
ここまでの話だけ聞くと、「じゃあAirflowと何が違うの?Airflowじゃダメなの?」ってことになると思うのですが、使っている所感としては、「使っているクラウドがAWSに閉じていて、且つ小規模にデータパイプラインを作りたい場合」には、AWS Data Pipelineはいいかなと思います。また、Pythonなどがチームのメインの言語ではない場合も、定義ファイルはJsonでコードはほぼSQLとシェルから好きな言語を使うとかができるので、Airflowなどに代表されるPythonでDAGを定義するなどもなく、有効です。
利用シーンとしては、以下の記事にあるように、データがRDSに入っていて、RDSからS3にData Pipelineでデータを定常的に持ってきて、そこからAthenaで分析するといった場合は有効かなと思います。
そのほかにも、例えば以下のようなシチュエーションが考えられます。
- 複数のデータソースにあるデータを「労力をかけずに」まとめて、定常的に分析したい場合
- AWS Data PipelineのTemplateで用意されているような典型的なデータパイプラインに加えて、プラスαの処理内容で済みそうな場合
- 複雑なデータパイプラインを作るまでの規模ではなく、ごくごく少人数でデータパイプラインの構築・運用をする必要がある場合
使っている感覚ですが、条件に応じた動的なパイプラインの制御や、タスクの依存関係が大きくなった場合などにおいては、自前でAirflowなどを立てて運用するなどが良いと思います。大規模になっていくと、ジョブの依存関係などを把握するのがツライと思います*2。
ちょっと癖があるのも事実ですが、1人〜2人でメインで運用しないといけなくて、データソースがそれほど多くならず、とりあえずパイプラインを作れればいいみたいなシチュエーションにおいては、Data Pipelineは有効かなと思います。
料金
料金は以下より。例えば東京リージョンで、1日に一回くらいの頻度であれば、約0.57$なので、めちゃめちゃ安いです。これに加えて、実行時に使用するEC2やEMRの代金は別でかかります。
実際にやってみる
0. 今回作るパイプライン
今回は、RDSにあるデータベースのテーブルをS3にコピーするパイプラインを実際に作ってみたいと思います。
1. データパイプラインの初期設定をする
それでは、実際にデータパイプラインを作ってみます。まずは、コンソール上から、data pipelineのサービスのところに飛びます。初めて作る場合は、以下のようなページになると思います。

「Get started now」からPipelineの初期設定ページに飛びます。すると、以下のような画面が出てきます。

ここで、「Source」のところから、以下の三つのうちのどれからPipelineを作成するかを選びます。
- Build using a template:あらかじめ用意されているTemplateから作成する場合
- Import a definition:JSONによる定義ファイルから作成する場合
- Build using Architect:AWSのコンソールから編集する場合
今回は、「Build using a template」に今回作りたいパイプラインのものがあるので、これを使います*3。他には、以下のようなTemplateが用意されています。

このtemplateと似ているけどちょっと違うとかであれば、templateから作るのが最初はいいと思います*4。作ったパイプラインの定義は、「Architect」からExportすることができるので、コードベースで差分を管理したい場合などは、これを利用するのがいいと思います。既存のパイプラインに読み込みをさせることはできないみたいですが。。。
次に、実行のスケジュールやログをS3のどのバケットにおくか、IAM Rolesの設定をします。実行環境によっては、この設定をちゃんとする必要があるのですが、それについては少し長くなるので別の記事で書きたいと思います。ここまできたら、「Edit in Architect」を押します。

すると、以下のような画面が出てきます。左側にパイプラインの各コンポーネントとフローが描かれ、右側に各コンポーネントの詳細な設定を行うことができる画面があり、下にパイプラインの設定に関するWarningやErrorがでるコンソールがあります。各コンポーネントの詳細や設定方法については、下の「使い方の参考」のところにいくつかリンクを貼っておきますので、そちらをご参考ください。

これらを設定して、うまくできたと思ったら、「Activate」ボタンを押して、実際に動かします。ボタンを押すと、以下のようにどのActivityが今どの状態かがわかる画面に遷移します。ここでジョブの状態やキャンセル、再実行などをすることができます。

使い方の参考
Data Pipelineの構成要素
上の「実際にやってみる」のところでいくつか出てきた構成要素については、以下の記事が参考になると思います。
terraformの対応状況とコードの管理方法
terraformを使ってインフラの管理をしている人はきになる対応状況ですが、以下のリンク先にあるように、現時点では外側の箱だけ作ることができるようです。
なので、terraformを使って箱だけ作って、あとはjsonでpipelineのフローを管理しつつ、aws cli経由でpipelineのアップデートをするようにするか、jsonとcliだけでやるかの感じが今の所思いついているものです。
コードをファイルから実行したい場合などは、S3に置くのがdata pipelineだとルールなので、コードとかもjsonと一緒にセットでgitとかで管理するようなイメージになると思います。
参考
以上になります。それでは。
【Git】macを新しくしたときにgitをインストールしてGithubの設定もする手順
こんにちは。
久しぶりに新しいmacで作業し始めているのですが、これを機に初期セットアップのところをまとめておこうかなと思います。
brewのインストール
brewをまずは入れます。途中でXcodeもインストールするアナウンスが出ると思いますが、普通にそれもインストールしちゃう感じで。
$ ruby -e "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/master/install)"
gitのインストール
brewでインストールします。
$ brew install git
確認
以下のコマンドで確認できます。
$ git --version
Githubの設定
user名とemailを設定する
$  git config --global user.name "<username>"
$ git config --global user.email "<email>"
ssh-keyの作成
$ ssh-keygen -t rsa -b 4096 -C "<email>"
$ chmod 600 ~/.ssh/id_rsa
$ vim ~/.ssh/config

## 以下をコピーして貼り付けて保存
Host github
  HostName github.com
  User git
  IdentityFile ~/.ssh/id_rsa
公開鍵をGithubに登録
普通にGUIからやる。
確認
以下のコマンドで、成功したっぽいメッセージがでたらオッケー。
$ ssh github
世の中にはめちゃめちゃこの手の情報が溢れているけど、自分用のメモ。以上。
【Golang】AtCoderの精選過去問10問やってみた
こんにちは。
今日は、Goの練習がてら、AtCoderの問題を解いてみました。以下の記事を読んで、入門者向けの過去問精選10問があることを知ったので、それをときました。
解いたコード
第0問:WelcometoAtCoder
package main

import "fmt"

func main() {
	var a, b, c int
	var s string

	fmt.Scan(&a)
	fmt.Scan(&b, &c)
	fmt.Scan(&s)
	sumResult := a + b + c

	fmt.Printf("%d %s\n", sumResult, s)
}
第1問:Product
package main

import "fmt"

func main() {
	var a, b int
	fmt.Scan(&a, &b)

	if (a*b)%2 == 0 {
		fmt.Println("Even")
	} else {
		fmt.Println("Odd")
	}
}
第2問:Placing Marbles
package main

import "fmt"

func main() {
	var s string
	fmt.Scan(&s)
	result := 0

	for _, char := range s {
		if char == '1' {
			result = result + 1
		}
	}

	fmt.Println(result)
}
第3問:Shiftonly
package main

import (
	"bufio"
	"fmt"
	"os"
	"strconv"
	"strings"
)

func convertStringListToIntList(data []string) []int {
	intList := make([]int, len(data))
	for i, v := range data {
		intList[i], _ = strconv.Atoi(v)
	}
	return intList
}

func checkEven(data []int) bool {
	for _, d := range data {
		if d%2 == 1 {
			return false
		}
	}
	return true
}

func divEven(data []int) []int {
	for pos, d := range data {
		data[pos] = d / 2
	}
	return data
}

func main() {
	var n int
	result := 0
	fmt.Scan(&n)

	var sc = bufio.NewScanner(os.Stdin)
	sc.Scan()
	aString := sc.Text()

	aStringList := strings.Split(aString, " ")
	aIntList := convertStringListToIntList(aStringList)

	for {
		if !checkEven(aIntList) {
			break
		}
		result = result + 1
		aIntList = divEven(aIntList)
	}
	fmt.Println(result)
}
第4問:Coins
package main

import "fmt"

func main() {
	var fiveHundred, oneHundred, fifty, x int
	fmt.Scan(&fiveHundred)
	fmt.Scan(&oneHundred)
	fmt.Scan(&fifty)
	fmt.Scan(&x)

	result := 0
	for a := 0; a <= fiveHundred; a++ {
		for b := 0; b <= oneHundred; b++ {
			for c := 0; c <= fifty; c++ {
				if 500*a+100*b+50*c == x {
					result = result + 1
				}
			}
		}
	}
	fmt.Println(result)
}
第5問:SomeSums
package main

import (
	"fmt"
	"strconv"
	"strings"
)

func main() {
	var n, a, b, result int
	fmt.Scan(&n, &a, &b)

	for i := 1; i <= n; i++ {
		s := strconv.Itoa(i)
		tmp := 0

		for _, v := range strings.Split(s, "") {
			iv, _ := strconv.Atoi(v)
			tmp = tmp + iv
		}

		if (tmp >= a) && (tmp <= b) {
			result = result + i
		}

	}
	fmt.Println(result)
}
第6問:CardGameforTwo
package main

import (
	"bufio"
	"fmt"
	"os"
	"sort"
	"strconv"
	"strings"
)

func convertStringListToIntList(data []string) []int {
	intList := make([]int, len(data))
	for i, v := range data {
		intList[i], _ = strconv.Atoi(v)
	}
	return intList
}

func main() {
	var n int
	fmt.Scan(&n)

	var sc = bufio.NewScanner(os.Stdin)
	sc.Scan()
	aString := sc.Text()

	aStringList := strings.Split(aString, " ")
	aIntList := convertStringListToIntList(aStringList)
	sort.Sort(sort.Reverse(sort.IntSlice(aIntList)))

	aliceSum, bobSum := 0, 0

	for i, a := range aIntList {
		if i%2 == 0 {
			aliceSum = aliceSum + a
		} else {
			bobSum = bobSum + a
		}
	}

	fmt.Println(aliceSum - bobSum)
}
第7問:Kagami Mochi
package main

import (
	"fmt"
	"sort"
)

func main() {
	var n int
	fmt.Scan(&n)
	dList := make([]int, n)

	for i := 0; i < n; i++ {
		fmt.Scanf("%d", &dList[i])
	}
	sort.Sort(sort.IntSlice(dList))

	result := 0
	for i := 0; i < n; i++ {
		if i == 0 {
			result = result + 1
		} else {
			if dList[i-1] != dList[i] {
				result = result + 1
			}
		}
	}
	fmt.Println(result)
}
第8問:Otoshidama
package main

import "fmt"

func existCandidate(n, total int) (int, int, int) {
	for x := 0; x <= n; x++ {
		for y := 0; y <= n; y++ {
			if total == x*10000+y*5000+(n-(x+y))*1000 && 0 <= n-(x+y) {
				return x, y, n - (x + y)
			}
		}
	}
	return -1, -1, -1
}

func main() {
	var n, total int
	fmt.Scan(&n, &total)
	x, y, z := existCandidate(n, total)
	fmt.Println(x, y, z)
}
第9問:白昼夢
package main

import (
	"fmt"
	"strings"
)

func main() {
	var s string
	fmt.Scan(&s)

	s = strings.Replace(s, "dream", "D", -1)
	s = strings.Replace(s, "erase", "E", -1)
	s = strings.Replace(s, "Der", "", -1)
	s = strings.Replace(s, "Er", "", -1)
	s = strings.Replace(s, "D", "", -1)
	s = strings.Replace(s, "E", "", -1)
	s = strings.TrimSpace(s)

	if s == "" {
		fmt.Println("YES")
	} else {
		fmt.Println("NO")
	}
}
第10問:Traveling
package main

import (
	"fmt"
	"math"
)

func main() {
	preT, preX, preY := float64(0), float64(0), float64(0)
	var n int
	var t, x, y float64
	fmt.Scan(&n)
	result := true

	for i := 0; i < n; i++ {
		fmt.Scanf("%f %f %f", &t, &x, &y)
		disT := math.Abs(float64(t - preT))
		disX := math.Abs(float64(x - preX))
		disY := math.Abs(float64(y - preY))
		disXY := disX + disY

		if int(disT)%2 != 0 {
			if (disT < disXY) || (int(disXY)%2 == 0) {
				result = false
			}
		} else {
			if (disT < disXY) || (int(disXY)%2 == 1) {
				result = false
			}
		}
		preT = t
		preX = x
		preY = y
	}
	if result {
		fmt.Println("Yes")
	} else {
		fmt.Println("No")
	}
}
以上です。今後、他の問題も解いていきたい。それでは。
Google Dmainsを使ってドメインを取得したのでまとめる
こんにちは。
最近、プライベートでアプリ開発をしてみようと思って、ドメインを初めてGoogle Dmainsを使って取得したので、そのやり方をまとめます。
今、Firebaseでアプリケーションはホスティングして、DNSは今後のことも考えてGCPでやっているのですが*1、それとGoogle Dmainsをどうやって連携しているかも別の記事で書きたいと思います。
Google Dmainsとは
本家のサイトは、以下。Google Dmainsとは、Googleが提供するドメイン登録サービスのことです。類似サービスとしては、「お名前.com」などが有名だと思いますし、私も使っています。
「お名前.com」と同様に、利用可能なドメインの検索・購入・管理などを行うことができます。
Google Dmainsのメリットとしては、G Suiteでメールアドレスが作れることになると思います*2。
GCPなどを使っている場合には、全部Googleのサービスで管理することができて便利というのもあります。
ドメインの取得方法
Google Dmainsを使うにはGoogleアカウントが必要なので、もしGoogleアカウントを持っていない方は、新規で発行してください。新規でドメインを取得するには、Googleにログインして、Google Dmainsのサイトに行き、ドメインの検索画面にきます。
ドメインの検索窓で、自分が取得したいドメイン名を検索します。
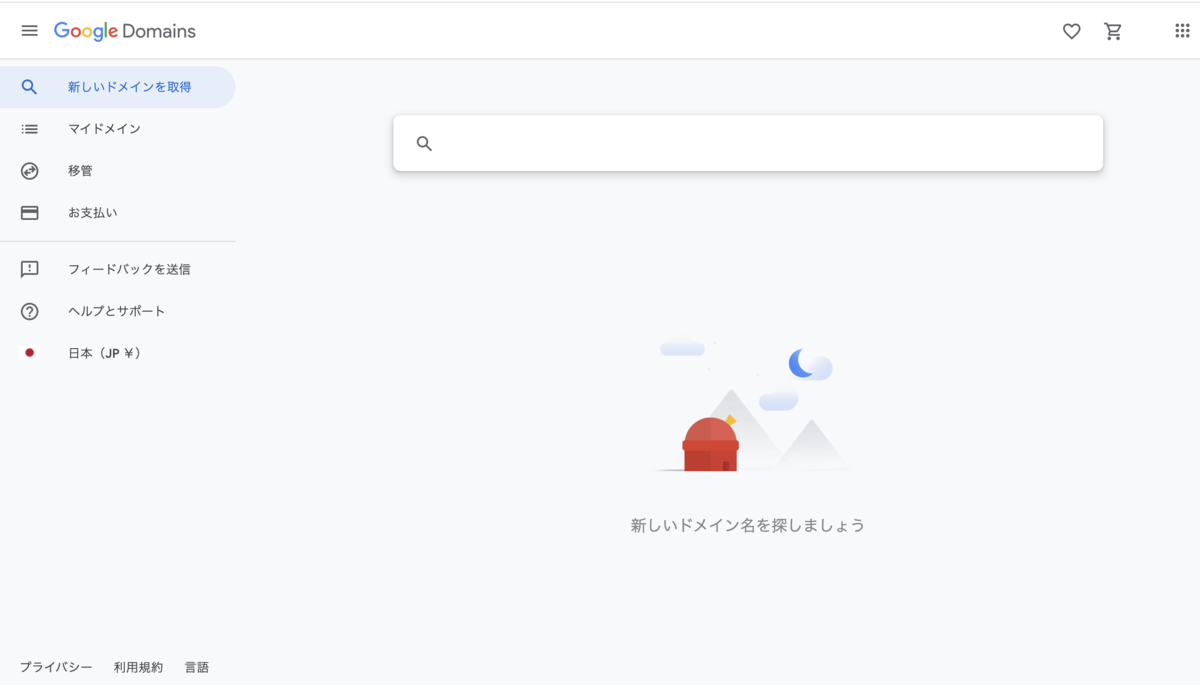
すると、利用可能なドメインが一覧で出てきますので、お好みのドメインをクリックして、カートボタンを押し、カートに入れます。
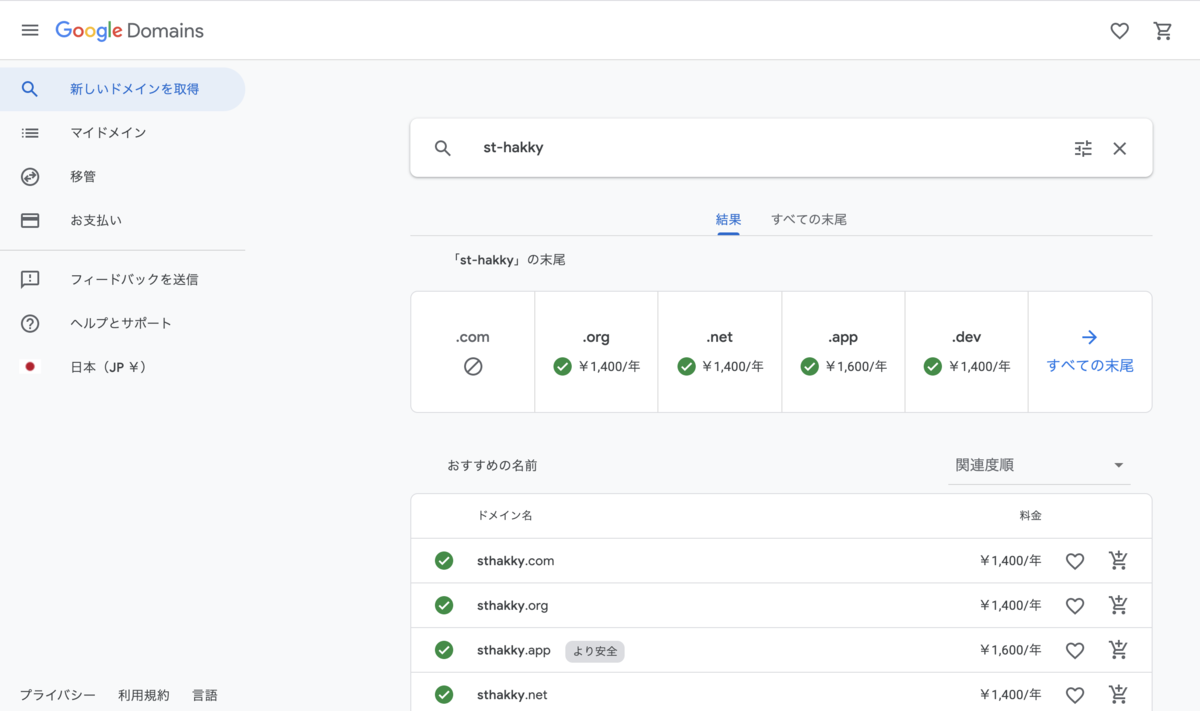
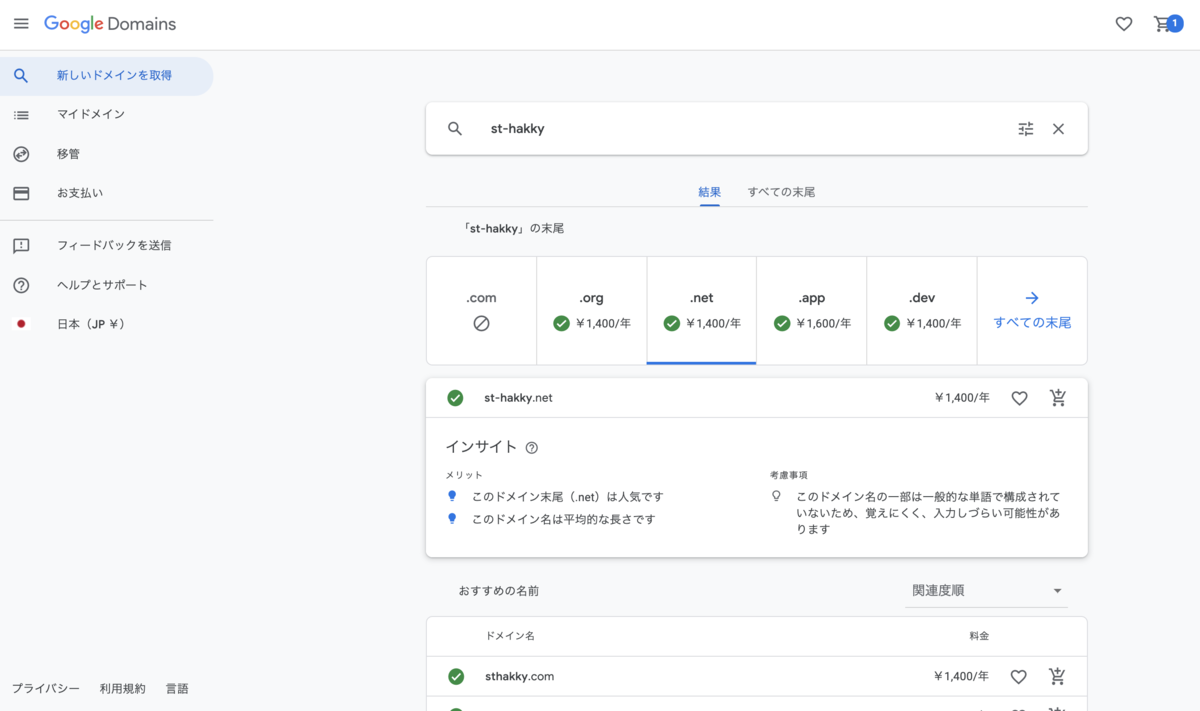
そして、カートに入れたドメインの購入手続きへと進みます。ここで、追加で料金を払うことによって、このドメインを使ってG Suiteのカスタムメールを利用することもできます。
以上で、ドメインの取得を行うことができます。簡単です。
その他にも、カスタムネームサーバーを利用することも可能ですが、それについては別の記事で紹介したいと思います。
参考
Data Portal(旧Data Studio)を真面目に触ってみたので、参考になった記事とかまとめる
こんにちは。
これまで、自社でRedashをメインで使っていたのですが、GCPの移行を部分的に進めているのもあって、Data Portal(Data Studio)を社内使ってみましたので、そのときに調べた内容とかハマったこととかを上げていきたいと思います。
まだ、使って4日とかその程度なので、間違っている箇所も大いにあると思いますが、その際はコメントいただけますと幸いです。
本家のドキュメント
Google Data Portalとは
Google Data Portal*1は、無料で利用できるBIツールです。Googleアカウントがあれば、利用することができます。
Google DocumentやGoogle Spreadsheet、Google Slideなどと同様に、共同編集機能や共有機能も有しており、またGoogle AnalyticsやBigQueryなどを通して、様々なデータを取り込み、可視化できます。
また、Redashなどと違って、SQLなどを基本的には書く必要がなく、プログラミング不要で使うことができるので、エンジニア以外のメンバーの方にもハードルが低く、導入もスムーズに行うことができると思います。
とりあえず使ってみる
とりあえず使ってみるために、いくつかのドキュメントを読みましたが、以下の連載記事が一番わかりやすかったです。
Data Studioの使い方が一通りわかります。その他にも、以下あたりの記事も参考になりました。
使ってみての感想
はい、まずそんなに多くのBIツールを使ったことがないワイの感想ですが、Data Studioは中長期的な運用や細かい分析を行うには、少し不便だなぁと思いました。
(多分)使う対象となるユーザー*2
使う対象になるユーザーは、他のBIツールよりも少し狭いかも…?と思いました。大元をたどると当たり前といえば当たり前なのですが、Google analyticsやGoogle Adsenseといったサービスを活用している、マーケティングや広告の運用担当者などが使うとハマるのかな…?と思いました。
逆に、ガリガリSQLを書いて行うようなデータ抽出を伴うようなものなどは難しいかなと思いました。今回、仕事で使ったのは今扱っているサービスで、AIを使ってデータを解析した数値の傾向の監視のためだったので、細かい設定や少し複雑な集計を行う必要があり*3、少しユースケースにあっていなかったのかな、と思いました。
使ってみたり、調べてみたりした中でのメリットとデメリットをまとめてみます。
メリット
Googleの肩の上にうまく乗ることができるユースケースでは、メリットをうまく享受できるな、と思いましたが、それ以外のものや、簡単な集計でも、大人数で運用する場合や、中長期的に運用を考えていくようなケースでは、他のBIツールを検討したほうがいいかなと思います。
デメリット
「クッソ、Redashなら…Redashならできるのに…!」って思ったことがメインになってしまいました笑
- データソースとレポートで行う可視化の機能の境界線が曖昧なため、データソースを誤って編集したら、データの意味などがレポート内部で変わってしまい、また影響範囲が読めなくなる
- データソースをちゃんと管理していないと、データソースの管理が煩雑になっていく
- 自由度が高すぎて、データを可視化するところ以外のところに労力を使ってしまう*6
- レポートのところで任意に新しいフィールドの定義を行うことができるので、データソース
- BI Engineが、Viewやカスタムクエリでは使えなくなる場合がある
使い方の面で参考になった記事
BI Engine
Googleが去年発表した、BI Engineというサービスです。BigQueryのデータを一定ボリュームだけキャッシュしておき、Data Portal上で利用するときに高速にデータにアクセスできるようにするものです。
詳しくは以下の動画と、
以下の記事に書いてあります。
BigQueryでのカスタムクエリー
BigQueryとの連携を今回はメインでやったので、備忘録的に書いておきます。自分でカスタムでクエリーを作って、データを取得することができます。Dateやカスタムのパラメーターをクエリに指定することもできます。
URLでパラメーターを指定する
BIツールとかで、Dashboardで使用する共通パラメーターをURLの中で指定することができたりします。自分が見るパラメーターが固定である場合、それをブックマークしておくと便利です。ただ、Data PortalはデフォルトではURLベースでパラメーターを指定することができないので、以下の記事のような感じで設定する必要があります。
仕事での活用
あんまり組織や業務でData Portalを運用しているのを見つけることができなかったのですが、以下の記事は参考になりました。もし誰か知っている人がいたら教えて欲しいです。
今日はData Portalを使ってみたときに参考になったサイトまとめと、メリットデメリットについて書いてみました。
それでは。
